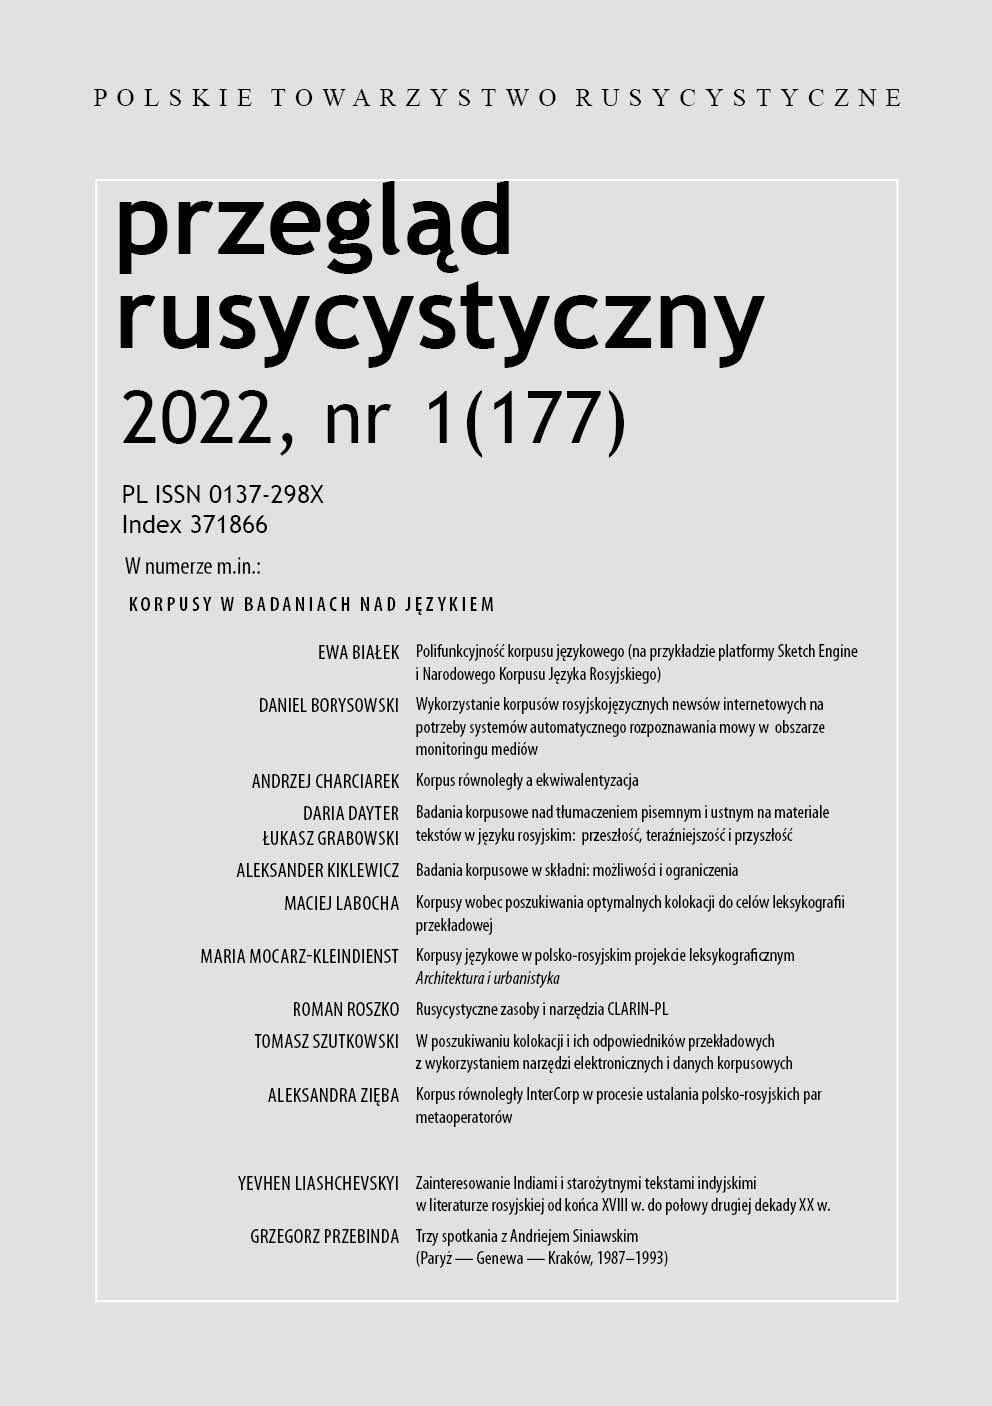
Цель статьи – показать возможности использования языкового корпуса в научных исследованиях и обучении иностранным языкам. В статье рассматриваются преимущества Национального корпуса русского языка и корпуса ruTenTen11 (Sketch Engine). Совокупность текстов, представленных в корпусах, являющихся современным инструментом для анализа языка, можно использовать для исследования изменений в языковой системе, а также для изучения языковой картины мира и в лексикографии. Языковые корпусы регистрируют историю слов, документируют изменения в их значениях. Автор статьи анализирует лексему и концепт Демократия в русском языке, а также значения нового заимствования контент и глагола озвучить. Автор сравнивает также знания о языке и культуре, содержащиеся в корпусе и ассоциативном словаре. Корпусы предоставляют полезную информацию о семантических особенностях слов, их коллокациях. С помощью изучения моделей сочетаемости можно реконструировать языковой образ мира. Языковые данные, извлечённые из корпусов, могут дополнять традиционные словари.
Автор статьи использовал открытыекорпусы NewsRu и Taiga, собирающие тексты интерет-новостей, для создания N-граммных языковых моделей для систем автоматического распознавания речи. Модели подверглись комплексной оценке (perplexity, WER, распознавание имен собственных, сравнение с базовой моделью и Google ASR). Автор использовал также рекурсивные нейронные сети для так называемого рескорина N-граммных моделей. Эффективность моделей оценивалась путем распознавания речи с новостного канала Россия 24 (оценке подверглись 37 файлов общей продолжительностью 1,5 часа). Выбор тестовых данныхсвязан с основной целью статьи – распознаванием речи в рамках так называемого медиа-мониторинга.
Настоящая статья посвящена возможностям использования польско-русского параллельного корпуса InterCorp в процессе установления переводных эквивалентов. В статье проанализированы тексты и функции InterCorp с учётом его пользователя – русиста. Подчеркнута полезность InterCorp в лингвистических исследованиях и в процессе перевода. Особое внимание уделяется установлению эквивалентов – эквивалентизации. В этом процессе существенную роль играет параллельный корпус, делающий возможным нахождение переводческих решений, которые нередко превосходят возможности единичного переводчика или переводного лексикографа. Текст послужил также основой для рассуждений о значении и перспективах эмпирических исследований в современном языкознании.
Корпусные исследования письменного и устного перевода на материале текстов на русском языке: прошлое, настоящее и будущее
В последнее время растет интерес к описательным и прикладным исследованиям перевода, проводимым с использованием методологий, основанных на корпусной лингвистике. В этой статье мы представляем обзор современных исследований в области письменного и устного перевода, проведенных с использованием корпусов русского языка, особенно параллельных и сопоставимых. В отличие от исследований, проводимых на других европейских языках (английском, французском, немецком, испанском и т. д.), значительная исследовательская традиция на русском языке остается относительно неизвестной широкой научной аудитории. Мы очерчиваем объем недавно проведенных исследований, представляем наиболее важные параллельные и сопоставимые корпуса с русским подкорпусом, используемые в исследованиях письменного и устного перевода, обсуждаем современные методы исследования, включая описательную и индуктивную статистику, и резюмируем избранные исследования, имеющие большое значение в дисциплине. Наконец, мы выявляем пробелы в исследованиях и намечаем направления будущих исследований.
Цель статьи – показать возможности использования интернет-корпусов в синтаксических исследованиях. Анализ языкового корпуса позволяет верифицировать аксиоматически смоделированные композиции знаков, при этом поиск соответствующих токенов может быть материальным (точный поиск) или алгоритмическим (лексико-грамматический поиск). Корпусные инструменты в первую очередь полезны для определения частоты единиц и их сочетаемости, а также регулярности языковых функций. На основании частотных характеристик типологические особенности разных языков можно описать с помощью выбранных параметров. Анализ корпуса также позволяет проверить, является некоторое валентное свойство слово отмеченным, и определить его функциональность. Автор показывает, что использование интернет-корпуса в синтаксических исследованиях имеет определенные ограничения. В случае частых явлений, особенно в разговорной речи, анализ корпуса эффективен, но он не всегда позволяет задокументировать явления, которые менее типичны и стилистически маркированы. Это особенно затруднительно в случае менее частых, но системно обусловленных единиц. Автор заключает, что корпус должен быть одинаково способным описывать явления речи и явления языковой системы. Эффективность корпусного анализа выше при условии, что дополнительно употребляются другие методы, например, анализ текстов, анализ словарных дефиниций, интроспекция, анкетирование и др.
В статье предпринимается попытка верификации результатов поиска в основном и газетном корпусах НКРЯ коллокатов российских лексем прожить и пережить (как неметафорических эквивалентов польской лексемы przeżyć). Основной целью исследования является определение пригодности 50-и начальных вхождений в данных корпусах для переводной лексикографии и дидактики. В статье автор представляет лексикографический и дидактический контексты анализа, приводит установленные в предыдущих своих исследованиях с упором на семантику и употребление пары эквивалентов (с учетом сочетаемостных схем и рядов), а также указывает не вызывающие сомнений по соотношению с определенной семантикой примеры коллокатов встречаемых в анализируемом материале.
В статье описывается полезность ресурсов языковых корпусов и корпусной платформы при создании польско-русского словаря "Архитектура и градостроительство". Во время анализа были использованы следующие ресурсы: Национальный корпус польского языка, Национальный корпус русского языка, Польско-русский корпус Варшавского университета и платформа Sketch Engine. Показано, что на разных этапах составления словаря внедрение ресурсов происходит с разной интенсивностью. Языковые корпусы (вместе с доступными инструментами) наиболее полезны на первых этапах, т.е. при составлении словарных статей. В гораздо меньшей степени языковые корпусы используются в процессе поиска русских эквивалентов из-за относительно небольшой коллекции специализированных и бытовых текстов, доступных в параллельных корпусах. Часто полученные результаты имеют лишь ориентировочное значение. Важно объединить данные, извлеченные из различных корпусных ресурсов, чтобы получить информацию, релевантную для содержания заголовочной словарной статьи cоставляемого словаря.
Статья посвящена многоязычным ресурсам, включающим в себя и русский язык, которые уже ранее были созданы и которые в настоящее время находятся в процессе разработки консорциумом CLARIN-PL. В статье также рассматриваются предлагаемые пользователям, заинтересованным в анализе русскоязычных ресурсов, инструменты и услуги.
Статья посвящена проблеме выделения устойчивых словосочетаний (коллокаций) и установления их переводческих эквивалентов на материале польского и русского языков. Многоязычные языковые единицы были предметом лингвистических исследований в различных аспектах языка в течение многих лет. Тем не менее, относительно немного лингвистов и переводчиков используют данные электронных корпусов в своей работе, которые в XXI веке должны стать важным источником лингвистической информации, включая реальные и потенциальные переводческие эквиваленты. Автор обсуждает возможности использования компьютерной программы как одного из методов извлечения словосочетаний из текстов и проводит анализ избранных единиц в параллельном корпусе.
Настоящая статья посвящена описанию возможностей, которые предоставляются параллельным корпусом InterCorp при переводе польских метаоператоров на русский язык и обнаружению в текстах аналогичных русских конструкций. Автор обсуждает вопрос о трактовке понятий репродукт, многолексемная единица и фразема в трудах польских лингвистов, которые всё больше подчёркивают необходимость помещения в одноязычных и многоязычных словарях упомянутых образований. Особенное внимание обращается на предоставленные Войцехом Хлебдой метаоператоры, которые служат вспомогательным инструментом в процессе извлечения из текстов воспроизводимых сверхлексемных образований. Описываются возможности и ресурсы польских и русских коллекций, содержащихся в корпусе InterCorp, а затем проводится анализ выбранных метаоператоров разных категорий.
В статье рассматриваются причины возникновения интереса к древнеиндийским религиозно-философским текстам в русской культурной сфере, а также пути проникновения индийских текстов в русскую литературу. Рассматриваемый в статье период охватывает анализ произведений русской художественной литературы, появившихся во временных рамках конец XVIII века- середина XX века. Актуальность исследования заключается в том, что, учитывая современную тенденцию литературоведения к расширению сферы деятельности и синтезу с другими научными дисциплинами, данное исследование носит ярко выраженный междисциплинарный характер, привлекая для анализа категории культурной антропологии и индологии. Методологически в данной работе были применены методы сравнительного и сравнительно-исторического анализа, формальный метод, а также постструктуралистские методы интерпретации художественного текста, основным из которых является метод интертекстуального анализа.
В статье рассказывается о трех моих встречах с Андреем Донатовичем Синявским (1927–1997), русским писателем и литературным критиком, широко известным в 1970–1990 годах. Первоначально Синявский публиковался в СССР под своим именем, но с 1959 года его произведения нелегально появлялись на Западе под псевдонимом «Абрам Терц». Синявский-Терц оставался в эмиграции во Франции с 1973 до конца своей жизни. В первой части текста обсуждаются контакты, которые краковский подпольный журнал «Арка» и Анджей Дравич, великий польский знаток России, установили с русскими писателями в изгнании, жившими в Париже во времена железного занавеса (прежде всего Ириной Иловайской-Альберти, Натальей Горбаневской, Владимиром Максимовым и Андреем Синявским). Я восстанавливаю по памяти свою первую встречу с Синявским и Марией Розановой, его женой, в Фонтене-о-Роз под Парижем в 1987 году. Розанова, еще при жизни писателя, помогала мужу в его редакционной деятельности. Во второй части эссе я рассказываю о своей второй встрече с писателем в Женеве в 1988 году во время международной конференции «Тысячелетие крещения Киевской Руси», организованной профессором Жоржем Нива. В третьей и заключительной части я пишу о своей третьей встрече с Синявским и Розановой, которая произошла в Кракове в ноябре 1993 года, через два года после распада СССР. Результатом этой последней встречи стало интервью с Синявским и Розановой, подготовленное мной и Анджеем Романовским для еженедельника «Тыгодник повшехны» тридцать лет назад и опубликованное ниже с моими актуальными комментариями в виде сносок.
В рецензии анализируется монография Жукова А.В. «Очерки по фразеологической семантике», развивающая семасиологические идеи фразеологической теории профессора Жукова В.П. и являющаяся синтезом предыдущих исследований автора.
Приведенный выше текст представляет собой старый, но все еще актуальный разговор с известным русским писателем в изгнании Андреем Синявским (1925–1997) и его женой Марией Розановой (1921 г.р.) – в 1983–2001 гг. главным редактором журнала «Синтаксис» (издавался на русском языке в Париже). Это интервью, записанное в Кракове в конце 1993 года двумя сотрудниками краковского «Тыгодника Повшехного» и филологами из Ягеллонского университета, в основном касается драматической ситуации в Российской Федерации после кровавого конфликта между президентом Борисом Ельциным и Верховным Советом в октябре 1993 года. В отличие от большинства представителей тогдашней демократической российской интеллигенции, как в России, так и в изгнании, Синявские были решительно против Ельцина в этом конфликте. Они обвинили тогдашнего президента в том, что, сражаясь из пушек против оппозиции, даже коммунистической, он непростительно попирал закон и способствовал росту презрения ко всякой демократии со стороны зарождающегося российского общества.
 10.31261/pr

 Język Polski
 Русский
 English